DockerHub の Automated Build を使ってみる
自分で作ったイメージをローカルでビルドしてもよいのですが、Pushしたらビルドしてくれるフローをサクッと作りたいなぁと思って調べていたところ、DockerHubのAutomated Build が使えそうなので、試してに使ってみました。 設定自体は非常に簡単でした。
Demoアプリ
package com.example.demo;

import java.time.LocalDateTime;

import org.springframework.stereotype.Controller;
import org.springframework.ui.Model;
import org.springframework.web.bind.annotation.GetMapping;

@Controller
public class DemoController {

  @GetMapping("/")
  public String index (Model model) {

    model.addAttribute("time", LocalDateTime.now().toString());
    model.addAttribute("version",
      System.getProperty("java.version")
      + ", "
      + System.getProperty("java.vendor")
      + ", "
      + System.getProperty("java.vm.name")
    );
    return "index";
  }
}
- テンプレートエンジンはThymeleafを利用しています。
<!DOCTYPE HTM
<html xmlns:th="http://www.thymeleaf.org">
  <head>
    <title>Spring MVC: demo app</title>
    <meta http-equiv="Content-Type" content="text/html; charset=UTF-8" />
  </head>
  <body>
    <p>
      DATA: <span th:text="${time}"></span>
    </p>
    <p>
      Java version: <span th:text="${version}"></span>
    </p>
  </body>
</html>
- コードはこちらにおいてあります。
Dockerfile を作成
- Docker はあまり触り慣れていなかったので、Spring公式のTutorialを参考に作成していきました。
- 最初はローカルでビルドしたFat jar をCopyしてイメージを作成する方法で進めました。
FROM openjdk:11.0.4-jdk-slim
VOLUME /tmp
ARG JAR_FILE
COPY ${JAR_FILE} demo.jar
ENTRYPOINT ["java","-jar","/demo.jar"]
openjdk:11.0.4-jdk-slimを利用しました。VOLUME /tmpはSpringBootがTomcat用のworkディレクトリを/tmp配下にデフォルトで作成するために記載しています。(今回のDemoアプリだと不要ですが)- デモアプリのビルドを実行し、Dockerビルドします。
docker build ./ -t dockerhub-automated-build-demo --build-arg JAR_FILE=target/demo-0.0.1-SNAPSHOT.jar
- コンテナを起動します。
docker run --rm -d -p 8080:8080 -t dockerhub-automated-build-demo
- これで
localhost:8080にアクセスすると画面が表示されます。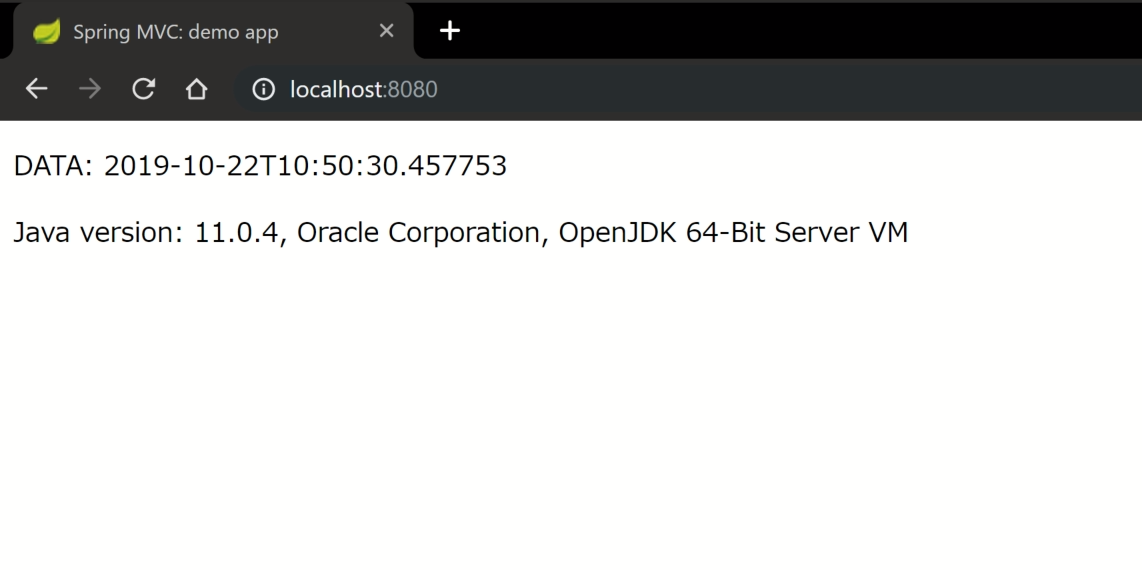
- この方法でも個人で遊ぶ分にはよいのですが、チームに配布するとかなったらアプリのビルドも含めてできた方がより移植性が高くていいなぁと思ったのと、Automated Buildだけで完結するようにしたかったので、何か他にいい方法がないか探しました。
Multi-Stage Build
- Tutorialにも記載されている、Multi-Stage Buildという機能を使うと上手いことできそうだとわかりました。
- Multi-Stage Buildとは、簡単に言ってしまえば1つのイメージを別のイメージへコピーできる機能のことです。
FROM openjdk:11.0.4-jdk-slim as build
WORKDIR /workspace/app

COPY mvnw .
COPY .mvn .mvn
COPY pom.xml .
COPY src src

RUN chmod +x mvnw && ./mvnw install -DskipTests
RUN mkdir -p target/dependency && (cd target/dependency; jar -xf ../*.jar)

FROM openjdk:11.0.4-jdk-slim
VOLUME /tmp

ARG DEPENDENCY=/workspace/app/target/dependency
COPY --from=build ${DEPENDENCY}/BOOT-INF/lib /app/lib
COPY --from=build ${DEPENDENCY}/META-INF /app/META-INF
COPY --from=build ${DEPENDENCY}/BOOT-INF/classes /app
ENTRYPOINT ["java","-cp","app:app/lib/*","com.example.demo.DemoApplication"]
- 上の場合だと、1番目の
FROMでアプリケーションのビルドを実行し、そのイメージを2番目のFROM以降でコピーして利用しています。 - 4つのレイヤに分かれていて、最後のレイヤはアプリのソースとconfigurationが含まれています。
- targetディレクトリをイメージに含めていないので、ある程度最適化はされています。
- tutorial を元に作成しましたが、
RUN chmod +x mvnw && ./mvnw install -DskipTestsとなっている部分は、tutorialではRUN ./mvnw install -DskipTestsとなっていますが、Automated Build で動かした時に./mvnw: Permission deniedでエラーとなったので変えました。 - ちなみにこのMulti-Stage Buildだとキャッシュとかないので、アプリのビルドのたびにライブラリとか全てダウンロードすることになるので、時間はかかってしまいます。
Automated Build の設定
Spring WebFlux + DynamoDB で非同期処理を書いてみる
はじめに
reactiveプログラミングって恥ずかしながらよく知らなかったのですが、去年AWS SDK for Java 2が登場したりとかSpring5.0からSpring WebFluxが追加されたりとかして認識し始めて、Javaでもそんなことができるのかと興味がわいたのでちょっと触ってみました。 慣れ親しんでいるDynamoDBと簡単に実装できそうな Spring WebFlux を使ってサンプルを作ってみました。
サンプルの内容
- 住所.jp から取得した都道府県の住所をDynamoDBへ登録(全都道府県突っ込むのは面倒だったので実際には東京都と周辺の県のみ)
- 使用した項目は以下の通り
- DynamoDBのテーブル定義は以下の通り
{
  "AttributeDefinitions": [
      {
          "AttributeName": "addressCode",
          "AttributeType": "N"
      },
      {
          "AttributeName": "prefectureCode",
          "AttributeType": "N"
      }
  ],
  "TableName": "address-list",
  "KeySchema": [
      {
          "AttributeName": "addressCode",
          "KeyType": "HASH"
      }
  ],
  "GlobalSecondaryIndexes": [
      {
          "IndexName": "Index-prefectureCode",
          "KeySchema": [
              {
                  "AttributeName": "prefectureCode",
                  "KeyType": "HASH"
              }
          ],
          "Projection": {
              "ProjectionType": "ALL"
          }
      }
  ],
 ・
 ・
 ・
- 住所コードをHASHに、都道府県コードをGSIに定義
- 登録した住所のうち都道府県コードが13(東京)を条件に住所の一覧を返却する
- 比較のためAWS SDK for Java 1,2 で同期、非同期処理を実装
- コードはこちらを参照いただければと思います。
構成
実装
pomにAWS SDK for Java 1,2 のを追加
- 今回使うのはDynamoDBだけなのでBOMで追加
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>software.amazon.awssdk</groupId>
      <artifactId>bom</artifactId>
      <version>2.5.51</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
    <dependency>
      <groupId>com.amazonaws</groupId>
      <artifactId>aws-java-sdk-bom</artifactId>
      <version>1.11.327</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
  ・
  ・
  ・
<dependencies>
  <dependency>
    <groupId>software.amazon.awssdk</groupId>
    <artifactId>dynamodb</artifactId>
  </dependency>

  <dependency>
    <groupId>com.amazonaws</groupId>
    <artifactId>aws-java-sdk-dynamodb</artifactId>
  </dependency>
  ・
  ・
  ・
</dependencies>
AWS SDK for Java 1 を使った同期処理
@RestController
public class DemoController {

  @GetMapping(path = "/address/tokyo", produces = MediaType.APPLICATION_JSON_UTF8_VALUE)
  public List<Address> getAddress() {
  ・
  ・
  ・
  }
    AmazonDynamoDB dbClient = AmazonDynamoDBClientBuilder.standard().build();
    Map<String, AttributeValue> lastEvaluatedKey = null;
    List<Address> responseList = new ArrayList<Address>();

    // loop to get all pages
    do {

      // create QueryResult
      Map<String, Condition> expressionAttributeValues = new HashMap<String, Condition>();
      Condition condition = new Condition();
      condition.withComparisonOperator(ComparisonOperator.EQ).withAttributeValueList(new AttributeValue().withN("13"));
      expressionAttributeValues.put("prefectureCode", condition);
      QueryRequest queryRequest = new QueryRequest().withTableName("address-list")
          .withExclusiveStartKey(lastEvaluatedKey).withIndexName("Index-prefectureCode")
          .withKeyConditions(expressionAttributeValues);
      QueryResult queryResult = dbClient.query(queryRequest);

      queryResult.getItems().stream().forEach(result -> {
        Address i = new Address();
        i.setAddressCode(result.get("addressCode") != null ? result.get("addressCode").getN() : "");
        i.setZipCode(result.get("zipCode") != null ? result.get("zipCode").getS() : "");
        i.setPrefectureCode(result.get("prefectureCode") != null ? result.get("prefectureCode").getN() : "");
        i.setPrefectureNama(result.get("prefectureNama") != null ? result.get("prefectureNama").getS() : "");
        i.setCityName(result.get("cityName") != null ? result.get("cityName").getS() : "");
        i.setDistrictName(result.get("districtName") != null ? result.get("districtName").getS() : "");
        i.setBlockName(result.get("blockName") != null ? result.get("blockName").getS() : "");
        responseList.add(i);
      });

      // loop until lastEvaluatedKey is empty
      lastEvaluatedKey = queryResult.getLastEvaluatedKey();
    } while (lastEvaluatedKey != null);

    return responseList;
AWS SDK for Java 2 を使った非同期実装
- こちらには
producesにMIMEタイプapplication/stream+jsonを指定 - レスポンスはAddressクラスのFlux
@RestController
public class DemoController {

  @GetMapping(path = "/address/tokyo", produces = MediaType.APPLICATION_STREAM_JSON_VALUE)
  public Flux<Address> getAddressWithStream() {
  ・
  ・
  ・
  }
Fluxは0個以上の値を返却するときに使用、0~1個の値を返却するときはMonoを使用する
DynamoDBAsyncClientを生成してqueryPaginatorを呼び出してQueryPublisherを取得する
    // not need to set exclusiveStartKey because of getting the next page of results automatically
    QueryPublisher queryPublisher = DynamoDbAsyncClient
                                      .create()
                                      .queryPaginator(request -> {
                                        request.tableName("address-list")
                                        .select(Select.ALL_ATTRIBUTES)
                                        .indexName("Index-prefectureCode")
                                        .keyConditionExpression("prefectureCode = :tokyo")
                                        .expressionAttributeValues(Map.of(":tokyo",
                                          software.amazon.awssdk.services.dynamodb.model.AttributeValue.builder().n("13").build()));
                                      });
- 自動的に次のページのデータも取得してくれるので
exclusiveStartKeyの設定とかは不要(ちなみにAWS SDK for Java 2なら同期処理でも同様に自動で取得できるようです) - あとは取得される結果を少々整形して
Fluxを返却すれば終わり
    return Flux.from(
      queryPublisher.items().map(map -> {
        Address i = new Address();
        i.setAddressCode(map.get("addressCode") != null ? map.get("addressCode").n() : "");
        i.setZipCode(map.get("zipCode") != null ? map.get("zipCode").s() : "");
        i.setPrefectureCode(map.get("prefectureCode") != null ? map.get("prefectureCode").n() : "");
        i.setPrefectureNama(map.get("prefectureNama") != null ? map.get("prefectureNama").s() : "");
        i.setCityName(map.get("cityName") != null ? map.get("cityName").s() : "");
        i.setDistrictName(map.get("districtName") != null ? map.get("districtName").s() : "");
        i.setBlockName(map.get("blockName") != null ? map.get("blockName").s() : "");
        return i;
      })
    );
挙動
$ curl -H "Accept: application/json" http://localhost:8080/address/tokyo
[{"addressCode":"100890900","zipCode":"100-8909","prefectureCode":"13","prefectureNama":"東京都","cityName":"千代田区","districtName":"永田町","blockName":""},{"addressCode":"176851000","zipCode":"176-8510","prefectureCode":"13","prefectureNama":"東京都","cityName":"練馬区","districtName":"桜台","blockName":""},{"addressCode":"135002200","zipCode":"135-0022","prefectureCode":"13","prefectureNama":"東京都","cityName":"江東区","districtName":"三好","blockName":""},{"addressCode":"183001300","zipCode":"183-0013","prefectureCode":"13","prefectureNama":"東京都","cityName":"府中市","districtName":"小柳町","blockName":""},
  ・
  ・
  ・
,{"addressCode":"151867400","zipCode":"151-8674","prefectureCode":"13","prefectureNama":"東京都","cityName":"渋谷区","districtName":"代々木","blockName":""},{"addressCode":"100650700","zipCode":"100-6507","prefectureCode":"13","prefectureNama":"東京都","cityName":"千代田区","districtName":"丸の内","blockName":"新丸の内ビルディング 7階"}]
$ curl -H "Accept: application/stream+json" http://localhost:8080/address/tokyo
{"addressCode":"100890900","zipCode":"100-8909","prefectureCode":"13","prefectureNama":"東京都","cityName":"千代田区","districtName":"永田町","blockName":""}
{"addressCode":"176851000","zipCode":"176-8510","prefectureCode":"13","prefectureNama":"東京都","cityName":"練馬区","districtName":"桜台","blockName":""}
{"addressCode":"135002200","zipCode":"135-0022","prefectureCode":"13","prefectureNama":"東京都","cityName":"江東区","districtName":"三好","blockName":""}
{"addressCode":"183001300","zipCode":"183-0013","prefectureCode":"13","prefectureNama":"東京都","cityName":"府中市","districtName":"小柳町","blockName":""}
{"addressCode":"101820400","zipCode":"101-8204","prefectureCode":"13","prefectureNama":"東京都","cityName":"千代田区","districtName":"神田練塀町","blockName":""}
{"addressCode":"100812700","zipCode":"100-8127","prefectureCode":"13","prefectureNama":"東京都","cityName":"千代田区","districtName":"大手町","blockName":""}
  ・
  ・
  ・
{"addressCode":"151867400","zipCode":"151-8674","prefectureCode":"13","prefectureNama":"東京都","cityName":"渋谷区","districtName":"代々木","blockName":""}
{"addressCode":"100650700","zipCode":"100-6507","prefectureCode":"13","prefectureNama":"東京都","cityName":"千代田区","districtName":"丸の内","blockName":"新丸の内ビルディング 7階"}
まとめ
ここにたどり着くまで結構時間がかかりました。。。そもそも非同期処理って何なの?とかWebFluxって何なの?とか、
AWS SDK for Java 1 だとページングされるので、AWS SDK for Java 2で非同期処理の時にはどうやって exclusiveStartKey をどうやって指定するんだ?とかとか。。
でも色々試行錯誤して多少は非同期処理の実装にも慣れたので良かったです。
ガベージコレクションについて基本的なこと
これまでガベージコレクションについて、あまり深く調べたりする勉強することもなかったのですが、
もう少しちゃんと知っときたいなぁと思い、Javaパフォーマンスでお勉強しました。
今回は「第5章 ガベージコレクションの基礎」の内容をもとに、Javaのガベージコレクションの基本的な部分についてまとめたいと思います。
そもそもガベージコレクションとは
ガベージコレクションとはJVMがオブジェクトのライフサイクルを管理してくれる機能のことです。
利用されなくなったオブジェクトを探し出し、それに関連付けられたメモリを解放、ヒープのコンパクト化を行います。
Java11(OpenJDK)では実験的なものも含め6つのガーベージコレクションのアルゴリズムが選択できます。
CMS、G1、ZGCはコンカレント型とも呼ばれています。
これらアルゴリズムが、それぞれ異なる方法でガベージコレクションを行っており、どれを選択するかによって性能に大きく影響してきます。
今回はシリアル型、スループット型、CMS、G1について説明しますが、まずは基本的なオブジェクトの管理の仕方について説明します。
オブジェクトの管理の仕方
基本的にオブジェクトは以下のような複数のヒープ領域に分割して管理されます。
- old領域
- young領域
- eden空間
- survivor空間
なぜ複数の領域で管理しているのかというと、Javaのオブジェクトはほとんどが一時的にしか利用されないため、領域を分けることによりオブジェクトの探索などの処理が高速化します。
young領域に対する処理(マイナーガーベージコレクション)
オブジェクトはまず、young領域の大部分を占めるeden空間に割り当てられます。young領域がいっぱいになると、アプリケーションスレッドをすべて停止してyoung領域を空にします。 その時、eden空間のオブジェクトは破棄、もしくは利用されているものは別の場所に移動します。移動先はsurvivor空間かold領域のいずれかとなります。 すべてのオブジェクトがなくなるため、young領域に対するコンパクト化は必要なくなります。 このyoung領域を空にする処理をマイナーガベージコレクションと呼び、今回説明する4つのガベージコレクションのアルゴリズムでは必ず発生しますが、処理自体はすぐに完了します。
old領域に対する処理(フルガベージコレクション)
old領域はyoung領域から移動してきたオブジェクトを管理する領域となります。
old領域もyoung領域同様、いっぱいになるタイミングが発生します。JVMはold領域内の使われていないオブジェクトを探して破棄するわけですが、ここの処理がアルゴリズムによって大きく異なります。
このold領域に対する手順をフルガベージコレクションと呼び、アプリケーションが停止する時間が長くなります。
シリアル型
一番シンプルなアルゴリズムで、クライアントクラス(単一CPU32ビットJVMとか)のマシンではシリアル型がデフォルトになります。
ヒープの処理を行うスレッドは1つで、マイナーガベージコレクションとフルガベージコレクション両方がアプリケーションスレッドを全て停止して実行されます。
フルガベージコレクションではold領域のコンパクト化まで行われます。
スループット型(パラレル型)
Java8のサーバクラス(複数CPUもしくは64ビットJVMとか)のマシンでは、スループット型がデフォルトになります。
Java7u4以降ではyoung領域、old領域に対する処理が複数スレッドで行われるため、マイナーガーベージコレクション、フルガベージコレクションともにシリアル型よりは高速になっています。
CMS(Concurrent Mark Sweep)
スループット型やシリアル側のようなフルガベージコレクションに伴う停止時間を短くするために、CMSは設計されました。
マイナーガーベージコレクションの際は、すべてのアプリケーションスレッドを停止して複数スレッドで処理をします。
フルガベージコレクションの際にはアプリケーションスレッドを停止しなくてすむように、複数のスレッドを使ってバックグラウンドでold領域の探索を行いオブジェクトの破棄を行います。アプリケーションスレッドはマイナーガベージコレクションの時しか停止しないので、停止時間の合計はスループット型よりはるかに短くなります。
ただし、old領域のコンパクト化をバックグラウンド処理の中では実施しないため、ヒープの断片化が進みオブジェクトの割り当てができなくなってしまった場合、シリアル型と同様にアプリケーションスレッドを停止し、単一スレッドでold領域のコンパクト化を実施します。
また、アプリケーションスレッドと並行してバックグラウンドでヒープの探索を行うため、CPUの使用率は大きくなります。
G1(Gargage 1st)
Java9以降のサーバクラスのマシンではG1がデフォルトになります。(Java9以降でもクライアントクラスの場合はシリアル型がデフォルト)
およそ4G以上の大きなヒープに対し、最低限の停止時間になるようにという思想の基、設計されています(ヒープ4GB以上じゃないと使用してはいけないというわけではありません)。世代に基づいて処理が行われるのは他と変わりませんが、大きな違いはヒープをリージョンという単位に分けて管理している点です。下記の絵はそのイメージですが、Oはold領域を、Sはsurvivor空間を、Eはeden空間を表しています。
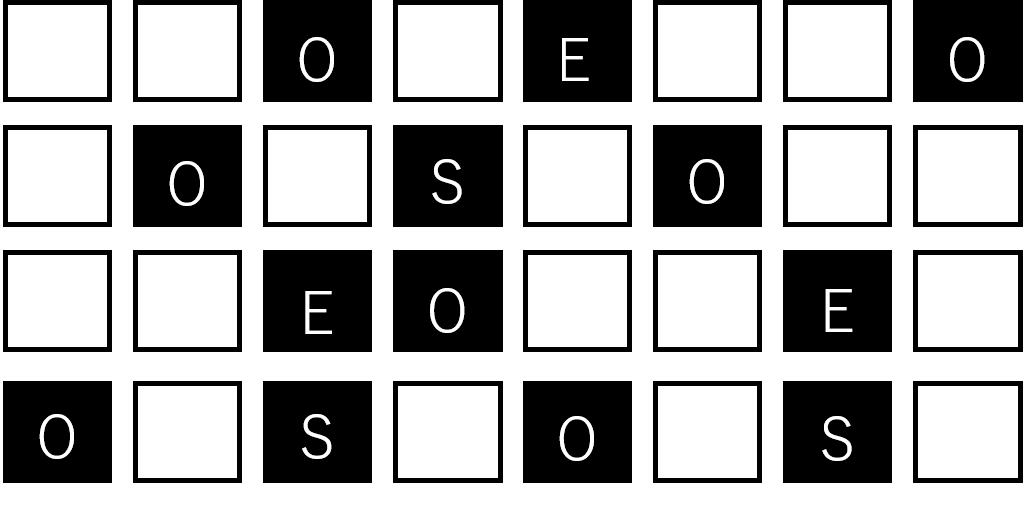
young領域を空にする場合は他のアルゴリズム同様、アプリケーションスレッドは全て停止します。
まとめ
沢山種類があってどれを選択すればよいか迷っちゃいそうですが、それぞれの仕組みを理解し、 アプリケーションの要件と照らし合わせながら、選択するのがよいと思います。 また今回調べていて、G1以外にもZGCやShenandoah GCなどあることを初めてしりました。 また余裕があったらこの辺も調べてみたいと思いました。
WSL(Ubuntu18.04)でJava11をインストールする
WSL(Ubuntu18.04)だと、aptでJava11のインストールができません。(2019年4月4日現在)
s-sakai@DESKTOP-9OQ6E9V:~$ sudo apt-get install openjdk-11-jdk
Reading package lists... Done
Building dependency tree
Reading state information... Done
.......
done.
s-sakai@DESKTOP-9OQ6E9V:~$
s-sakai@DESKTOP-9OQ6E9V:~$ java -version
openjdk version "10.0.2" 2018-07-17
OpenJDK Runtime Environment (build 10.0.2+13-Ubuntu-1ubuntu0.18.04.4)
OpenJDK 64-Bit Server VM (build 10.0.2+13-Ubuntu-1ubuntu0.18.04.4, mixed mode)
s-sakai@DESKTOP-9OQ6E9V:~$
18.10にアップグレードすれば行けそうだったのですが、
手動でダウンロードして設定したほうが手っ取り早そうだったので、
今回はこの方法で設定しました。
- java.netからtar をダウンロードして解凍する。
s-sakai@DESKTOP-9OQ6E9V:~$ wget https://download.java.net/java/GA/jdk11/9/GPL/openjdk-11.0.2_linux-x64_bin.tar.gz -O /tmp/openjdk-11+28_linux-x64_bin.tar.gz
s-sakai@DESKTOP-9OQ6E9V:~$ sudo tar xfvz /tmp/openjdk-11+28_linux-x64_bin.tar.gz --directory /usr/lib/jvm
s-sakai@DESKTOP-9OQ6E9V:~$ rm /tmp/openjdk-11+28_linux-x64_bin.tar.gz
- バージョンを確認する。
s-sakai@DESKTOP-9OQ6E9V:~$ /usr/lib/jvm/jdk-11.0.2/bin/java -version
openjdk version "11.0.2" 2019-01-15
OpenJDK Runtime Environment 18.9 (build 11.0.2+9)
OpenJDK 64-Bit Server VM 18.9 (build 11.0.2+9, mixed mode)
alternativeでパスを変更する
s-sakai@DESKTOP-9OQ6E9V:~$ sudo update-alternatives --install /usr/bin/java java /usr/lib/jvm/jdk-11.0.2/bin/java 10
s-sakai@DESKTOP-9OQ6E9V:~$ sudo update-alternatives --config java
There are 2 choices for the alternative java (providing /usr/bin/java).

  Selection    Path                                         Priority   Status
------------------------------------------------------------
* 0            /usr/lib/jvm/java-11-openjdk-amd64/bin/java   1101      auto mode
  1            /usr/lib/jvm/java-11-openjdk-amd64/bin/java   1101      manual mode
  2            /usr/lib/jvm/jdk-11.0.2/bin/java              10        manual mode

Press <enter> to keep the current choice[*], or type selection number: 2
update-alternatives: using /usr/lib/jvm/jdk-11.0.2/bin/java to provide /usr/bin/java (java) in manual mode
s-sakai@DESKTOP-9OQ6E9V:~$
- バージョンを確認する
s-sakai@DESKTOP-9OQ6E9V:~$ java -version
openjdk version "11.0.2" 2019-01-15
OpenJDK Runtime Environment 18.9 (build 11.0.2+9)
OpenJDK 64-Bit Server VM 18.9 (build 11.0.2+9, mixed mode)
参考
Ubuntu Linux 18.04 LTS / 18.10でOpenJDK 11を使いたい
Ubuntu 18.04 bionicにOpenJDK 11をインストールする
Installing OpenJDK 11 on Ubuntu 18.04
PostmanでXMLレスポンスのテストを書く
Postman結構使うようになってきて、最近はテスト機能も使っています。
XMLレスポンスの場合は以下のような感じでテストが書けます。
pm.test("test name", function () {
    var jsonObject = xml2Json(responseBody);
    pm.expect(jsonObject.value).to.eql("expected data");
});
サンプル
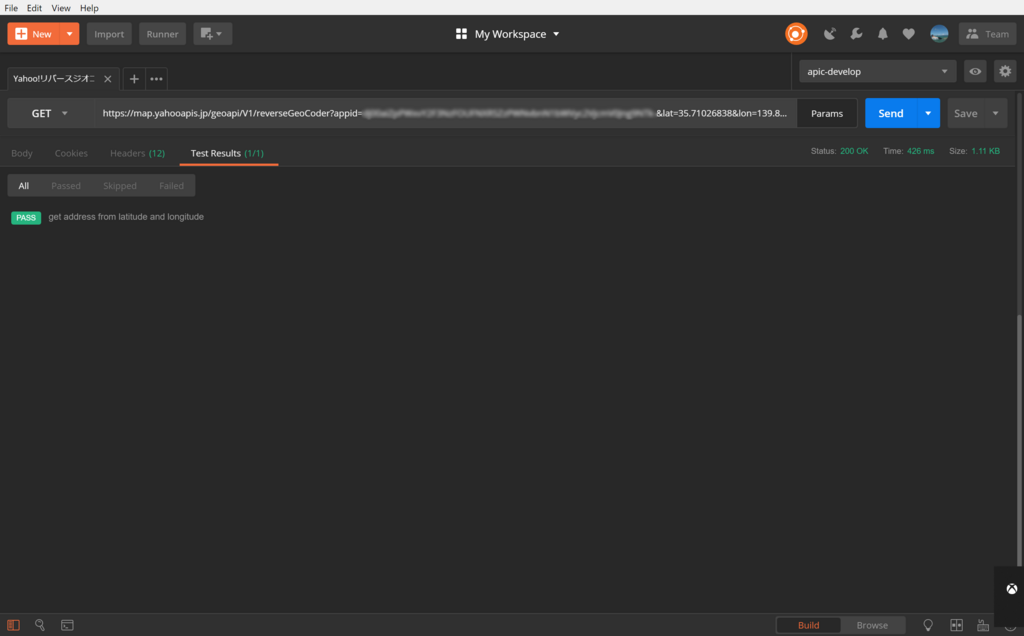
Yahoo!リバースジオコーダAPIを使って、緯度・経度から想定したものが返却されてくるかテストしてみます。
自分で発行したアプリケーションIDと検索したい緯度・経度をパラメータに設定します。
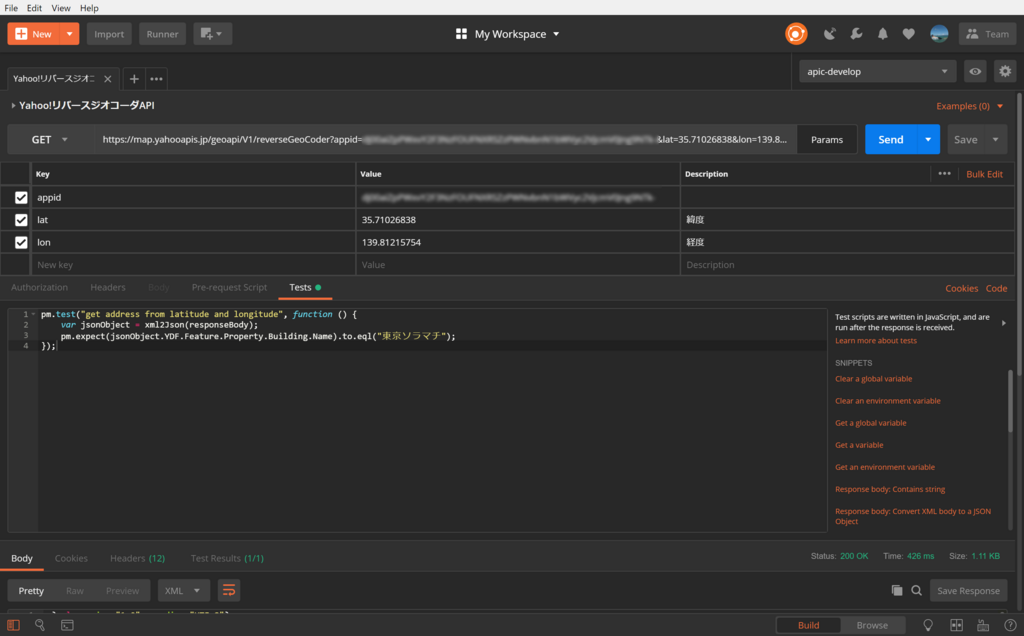
テストは以下のような感じです。
xml2JsonでXMLをJSONに変換します。検索した緯度・経度から東京ソラマチが返却されるかチェックしています。
pm.test("get address from latitude and longitude", function () {
    var jsonObject = xml2Json(responseBody);
    pm.expect(jsonObject.YDF.Feature.Property.Building.Name).to.eql("東京ソラマチ");
});
Sendボタンを押して実行すると、下記のようにレスポンスとテストの実行結果が確認できます。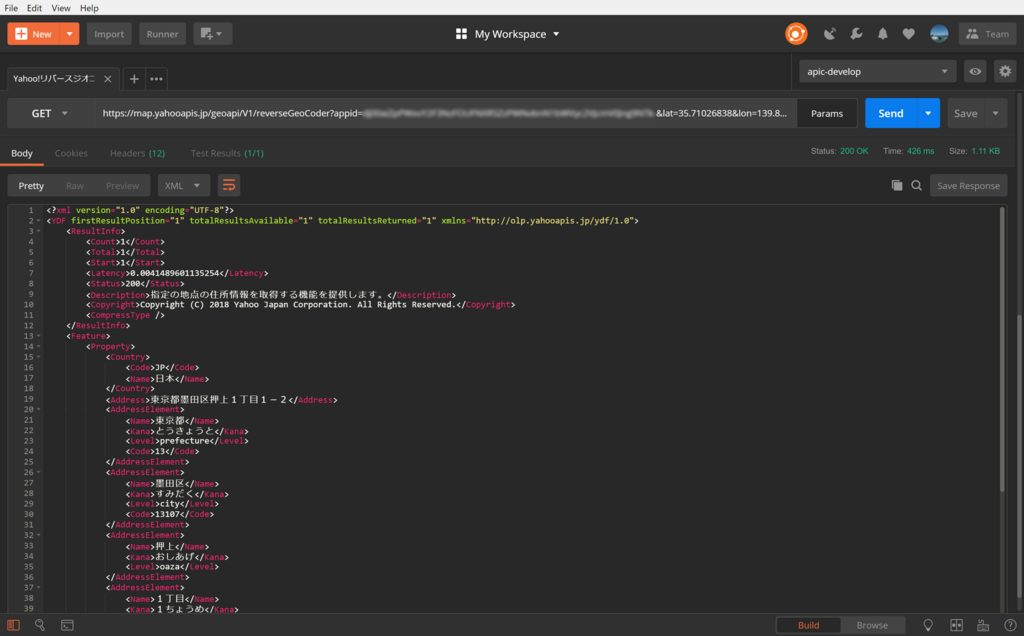
まとめ
Postman便利。
モブプログラミングで開発をやってみた
はじめに
去年あたりからモブプロの話をちらほら聞き始めてちょっと気になっていたのですが、チームの課題感的にマッチしそうだったので、数ヶ月間色々試しながらチーム開発に組み込んでみました。
ちょっとずつではありますが、上手く回りはじめたのと自分の中でも色々気づきがあったので、そのあたりを自分なりにまとめようと思います。
チーム開発で感じていた課題
そもそもモブプログラミングを取り入れようとしたきっかけですが、「なんか楽しそう!」というのももちろんありますが、最終的に取り入れたのは以下2つの課題を解決するためでした。
チーム内での知識の共有
現在自分含め4~5名のチームで、開発と運用を行っています。
そのため必要な技術要素も言語、ミドルウェア、インフラ(AWS)と多岐にわたるため、チームメンバーの技術力向上や知識の共有が重要だと考えていました。
勉強会などでそのあたりを解消するというのも当然あると思いますが、チームメンバーの半分は社外で開発を行っているという事情もあり、あまり気軽にできるものでもありませんでした。
モブプロであれば、開発をしながらそういった知識の共有が行えると思い、勉強会よりも効率的だと考えました。
コードレビューの時間と精度
自分のチームではレビューアーをランダムに選出しています。
レビューの観点はメンバーに伝えているものの、当然人によって指摘する内容に差は出てしまいます。レビューにかける時間も人によって差がでますし、経験の少ないメンバーは時間を多く取られてしまう傾向にあります。もちろん繰り返し行うことで習得していく訳ですから、それ自体悪いとは思っていませんが、開発の時間もしくはレビューの時間を圧迫したりして、本来かけるべき時間をかけられなかったりすることで、品質に影響しかねないなぁと考えていました。
モブプロであれば、常にレビューしながら(されながら)開発できるので、GitHub上でのコードレビューは不要となり、このあたりの懸念が解消されると考えました。
どのようにやったか
やり方はWEB+DB PRESS Vol.102をかなり参考にして自分達に合う方法を探していきました。
実施環境
専用の部屋などは確保できなかったので、MTGスペースをその時間だけレイアウトを変えて実施していました。会社の都合上専用スペースは確保することはできないので、毎回MTGスペースのレイアウト変更する必要があります。実施回数が増えれば増えるほど負担も増えるので、ここは改善したいポイントの一つです。
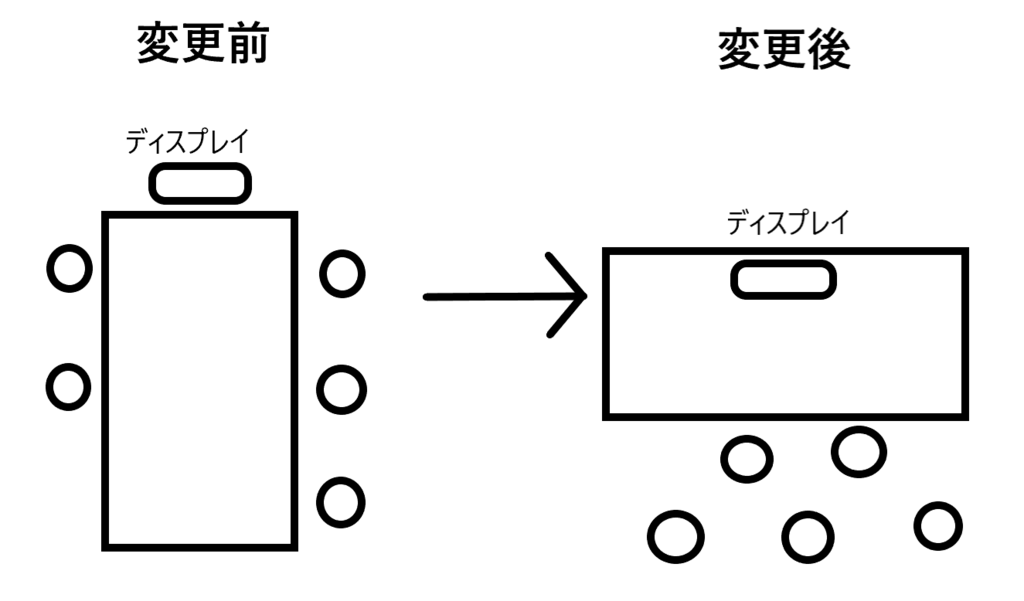
上の写真のように机を横にしてやることで、ドライバーは自然は体勢でプログラミングを行うことができます。
実施頻度
多い時で週2~3回行い、1回の実施時間は2~3時間としていました。
実施時間については、もう少しかけたいところではありましたが、社外で開発しているメンバーもいるので、あまり慣れない環境で長くやるのも負担が大きいと考えこのぐらいの時間にしました。
実は最初1時間とかでやってみたこともありましたが、さすがに1時間では大したアウトプットも出なかったので、2~3時間程度は1回のモブプロで時間を取るようにしました。
実施回数についてもメンバーの負担も考え、多くても週の半分程度としました。
開発環境
自分達の場合、Windows:Mac=4:1だったので、最初はWindows端末でやる想定でした(Macのメンバーはキーボードを持参)。が、いざやってみるとキーボードの設定がめんどくさかったり、思っていた以上に基本的な操作の部分で詰まることが多かったので(まぁそりゃそうですよね)、MacとWindowsそれぞれ準備し、片方使ってないときは調査用端末として利用していました。
AtomのTeletypeやCloud9などの利用も考えましたが、Macのメンバーが開発環境回りで詰まったときに誰も助けることができないので、今までみんなが使い慣れたIDEを各環境で利用するようにしました。MacのメンバーとWindowsのメンバーがバトンタッチするときはGitHubにPushして交代するようにしました。
どのような開発でやったか
最初の課題で上げさせてもらいましたが、ナレッジの共有だったりが大きな部分を占めていることもあり、メンバー間で差のなく難易度が低い開発はモブプロではやっていません。どのような開発で取り組んだかというと、
- 新しいFWを使った開発
- 少し難易度の高い新機能の開発
- あまりメンバーが触ってこなかったAWSサービスを使った機能やツールの開発
といったもので取り組んできました。
実際どうだったか
良かった点
課題に上げていたポイントは、モブプロで開発したものに関しては解消することができました。
また取り組みを始めてからは、チーム内の心理的安全が築きやすくなったと感じていて、全体的なコミュニケーションコストも下がったと個人的には感じています。
改善したい点
実施環境のところでも書きましたが、専用のスペースは確保したと思っていますが、こればっかりは物理的な制約もあるので難しいかなぁとも感じています。
また、そんなこと!?と思われるかもしれませんが、メンバー各人が休憩を自由にとれるようにしたいと考えています。いつでも休憩を取って良いというふうにしていますが、皆で何かしている最中に一人だけ休憩に行くのは、心理的ハードルが高い人もいるかなと感じています。
モブプロをやったことある方ならわかると思いますが、絶えず開発が進行していくので結構疲れます。ですので、各自で適切なタイミングで休憩をとってリフレッシュしないと最後まで集中して臨めません。
開発の場が最後までいい状態に保てるようにするためにも、各人が適当なタイミングでリフレッシュできるようにするのが大切かなと個人的には考えています。
まとめ
最初のうちは、うまくアウトプットを出せなかったり、沈黙が流れるみたいなこともあって、「イメージと違う!」と思ったりもしましたが、何度か繰り返していくうちに、ファシリテートの仕方とかもつかめてきて、それなりにうまく回せるようになったかなぁと感じています。
万能ではないとも感じていますが、自分と同じような課題感をもっている方がいたら、選択肢には入れておいてもいいと思います。
